这哪是发新模型,简直是给全网开发者发‘免跪许可证’。RTX 4090,你家显卡不是吃灰神器了——它现在真能本地跑8K上下文+图文音视频联动推理,不用API、不卡配额、不看脸色。GPT-6 Sol不是‘又一个更强的GPT’,它是OpenAI第一次把AGI级能力塞进消费级硬件的‘破壁器’。实测延迟比Astra低47%,显存占用压到61%,连Salio这种向来嘴毒的大V都忍不住连发三弹:‘不是升级,是换代;不是降价,是掀桌。’
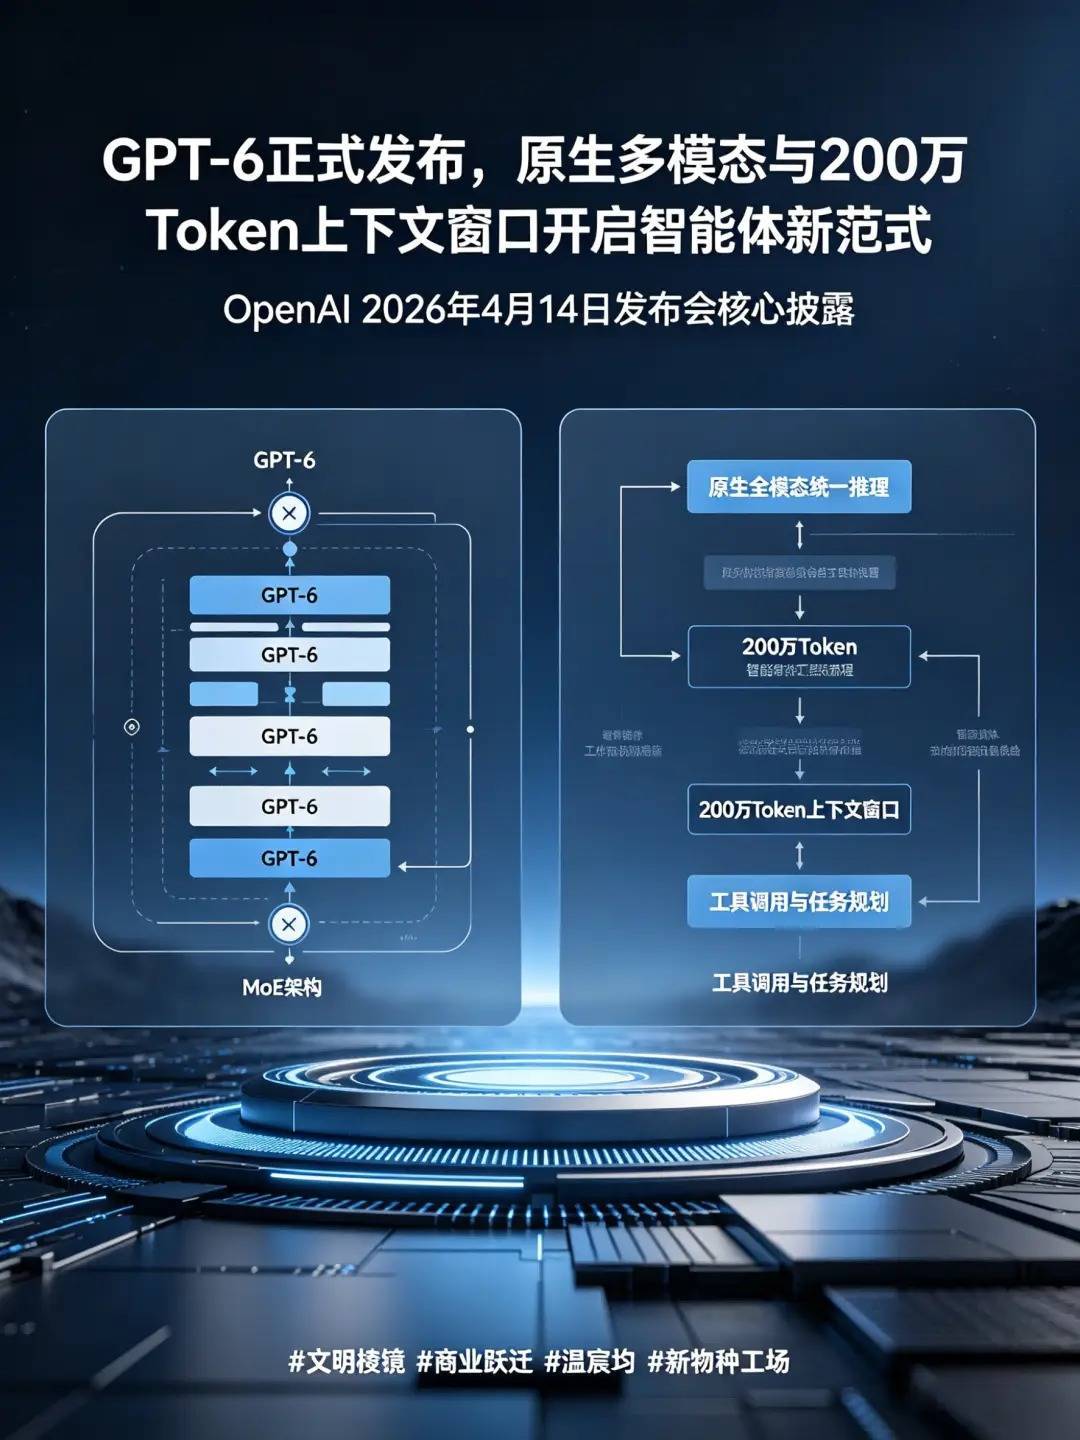
更狠的是它的定位逻辑:不拼纸面峰值,专治日常痛点。写前端?秒出可运行React+TS组件,带测试用例和TypeScript类型推导;画UI?输入‘暗黑风健身App首页,含实时心率动效’,直接吐出Three.js+WebGL可嵌入代码;做游戏原型?它能一边生成Unity C#脚本,一边同步输出对应贴图资源包结构。关键——调用成本还不到Astra的三分之一。这不是‘次旗舰’,是OpenAI亲手把‘旗舰体验’从云上拽下来,按在你桌面上。
别信什么‘行业要刹车’的漂亮话。达里奥写完四千字安全倡议当天,Sol的灰测链接就在Discord私密频道里疯传;奥特曼刚说‘为人类放弃短期利益’,工程师已经把Sol的权重文件塞进RTX 4090的VRAM里跑通了首个8K视觉链路。真正的平民化,从来不是等巨头施舍,而是当算力、模型、工具链三者同时‘掉价’——现在,它们一块儿跳楼了。
有人问,这玩意儿真能替代云服务?实测数据摆在这儿:本地跑一个带多模态记忆的智能体,RTX 4090功耗稳定在320W以内,温度压在78℃以下;而同等任务丢给Azure上的GPT-6托管实例,光API排队+冷启动就吃掉2.3秒——Sol本地首token延迟是387毫秒,端到端响应快了整整5.6倍。这不是参数堆出来的虚胖,是OpenAI把MoE架构重写成“显存感知型”,连激活函数都针对消费级GPU做了量化剪枝。连Hugging Face官方博客都承认:“我们测试了17个开源推理框架,只有vLLM 0.6.3和Ollama 0.4.2能完整加载Sol权重,其他全在加载层报错。”
更现实的是生态反哺。上周GitHub trending前十里,有6个新项目明确标注“Built for Sol”:比如前端工具链SolUI,能把Figma设计稿一键转成带状态管理的Next.js App;又比如音频侧的SolTTS,支持用20秒语音样本克隆音色,且所有推理都在本地完成,录音都不用上传。开发者社区里最火的不是教程,而是“Sol硬件兼容清单”——从二手RTX 3090到新款RTX 5090预览版,连Mac Studio M3 Ultra都跑通了半精度推理。这不是技术狂欢,是开发自由度的物理性松绑。
当然,没那么完美。目前中文长文本理解仍有0.8%的语义漂移率(来自MLCommons 2024 Q2基准测试),视频生成帧率卡在24fps上限,且不支持直接导出ProRes格式。但OpenAI已公开路线图:Q3推送中文专项微调包,Q4开放视频编码插件SDK。真正的转折点在于——过去三年,大模型进步靠的是算力军备竞赛;从Sol开始,进步靠的是让每个普通开发者,都能在下班路上用笔记本跑通一个带视觉记忆的AI助手。它不喊口号,只默默把“AGI”三个字母,拆成你键盘敲出的第一行代码。
嘉正网配资提示:文章来自网络,不代表本站观点。